AI 记忆的抗膨胀:从"淘汰谁"到"留下谁"
跨会话的项目记忆文件会像所有"活"的文档一样膨胀。本文记录一次从 26KB 到 14.7KB 的安全精简:为什么"热度评分淘汰"不可行(使用不可观测、低频高损会误杀),改成"准入三条",以及"先归档 → 先落点 → 后删除 → 再对账"的搬迁式精简流程与两个对账脚本。
 眠月AI Agent 工程 · 全栈开发
每个和 AI 协作者(Codex、Claude Code、CodeBuddy 这类)长期协作的人,迟早都会养出一个「项目记忆文件」:跨会话加载,记录环境事实与项目状态,差不多是给 AI 的一页长期备忘。
它天然会膨胀。我的那个文件从 13KB 一路滚到 26KB——每个会话往里追加,没人做减法。代价是它每轮对话都要进上下文,膨胀等于每次都在为历史付利息;更糟的是关键信息被淹没在叙述里。
于是有了这个问题:怎么安全地给它减重?
先否掉两条路
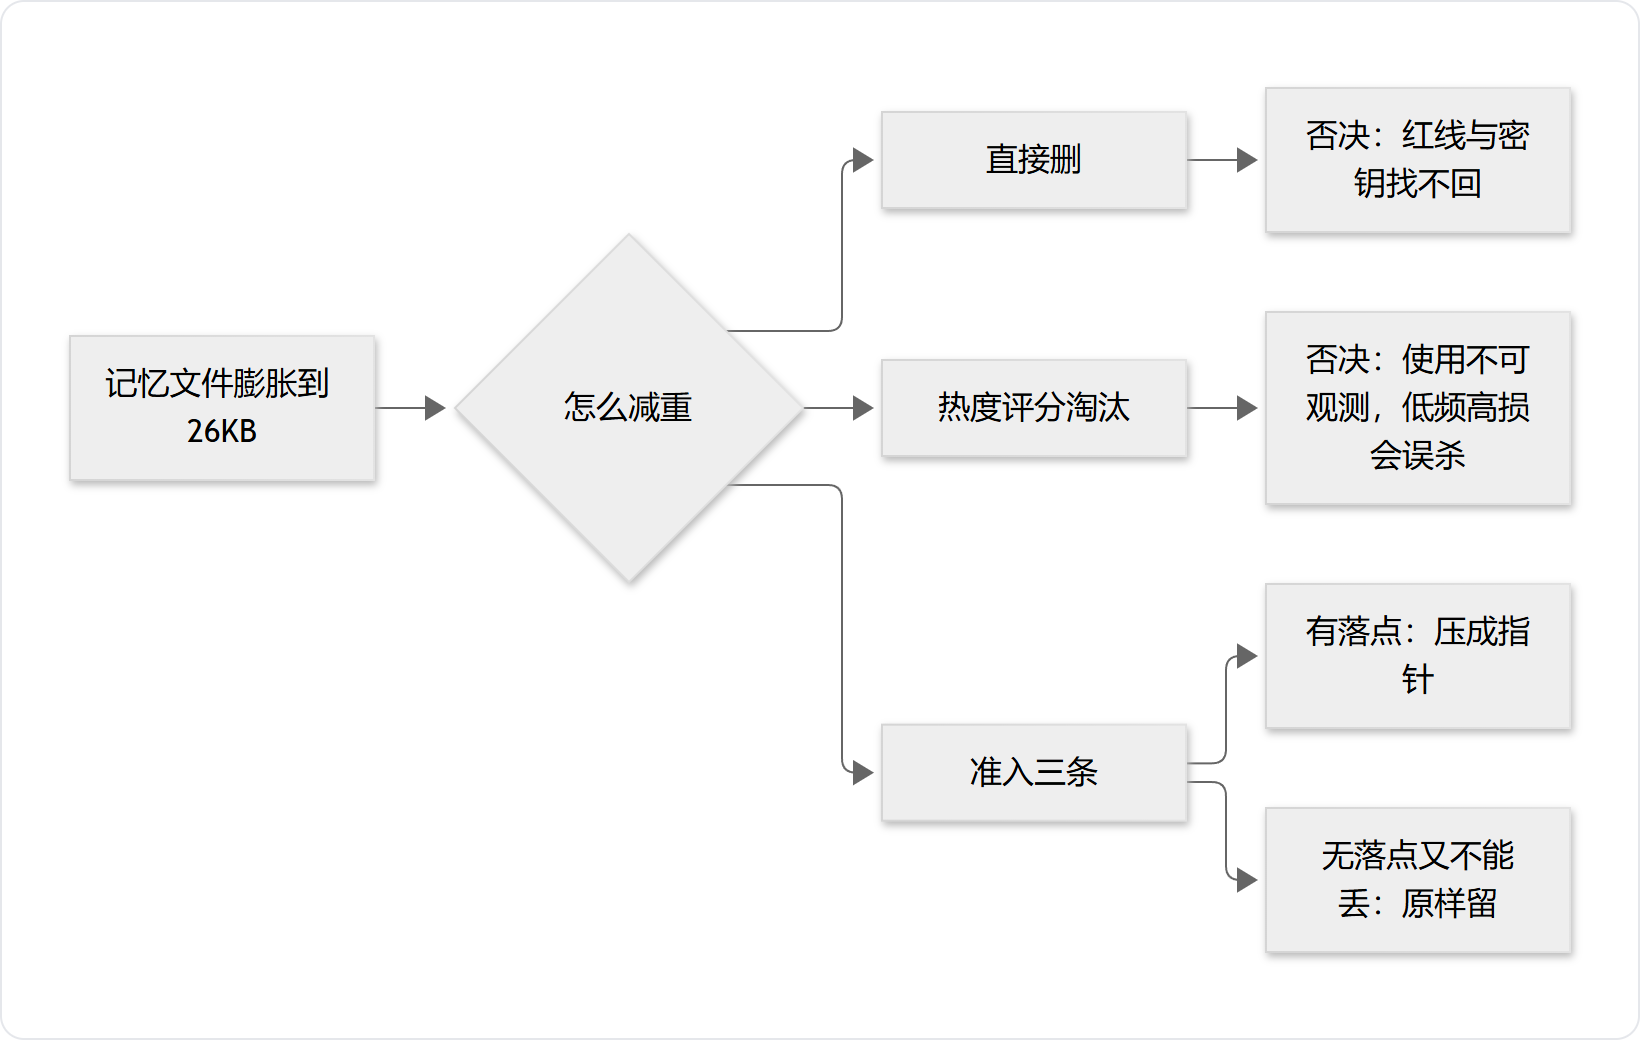
直接删。 不行——它同时装着「丢了就找不回」的东西:服务器信息、密钥位置、线上一句话红线。
热度评分淘汰(给每个区加计数器、按近期使用频率加权打分、低分优先压缩)。听起来很科学,实际有两处硬伤:
- 「使用」不可观测。文件是整体加载的,加载不等于使用;真正的使用是"某句话被引用了"。要让 AI 自己逐次记账,数据很快会烂——而脏数据比没有数据更危险,因为它看起来权威。
- 低频不等于可丢。密钥位置、备份路径这类信息可能几个月才用一次,但真丢了你没有任何地方能找回。纯按分数排序,第一批被压掉的就是这种「低频高损」条目。
这两条合起来给出一个教训:淘汰需要观测数据(拿不到),准入只需要判定(可以静态做)。于是换方向——不研究"淘汰谁",只定义"留下谁"。
准入三条
留在记忆文件里的东西只允许三类:
| 类 | 判据(一句话) |
|---|---|
| ① 低频但不能丢 | 丢了,别处能找回吗?找不回 = 留 |
| ② 状态 + 核心设计 | 接手者不看到它,会重复已定的事、或基于旧状态行动吗? |
| ③ 导航 | 要改 X,不看到它能不能三步内说出改哪个文件? |
配套一个机制:有落点的条目压成指针;没有落点又不能丢的原样留。
也就是说,被"移出"的内容必须有家——项目细节去项目交接文档、教训去经验库、过程去当日流水。这个机制让精简的动作从"删"变成了"搬迁"。
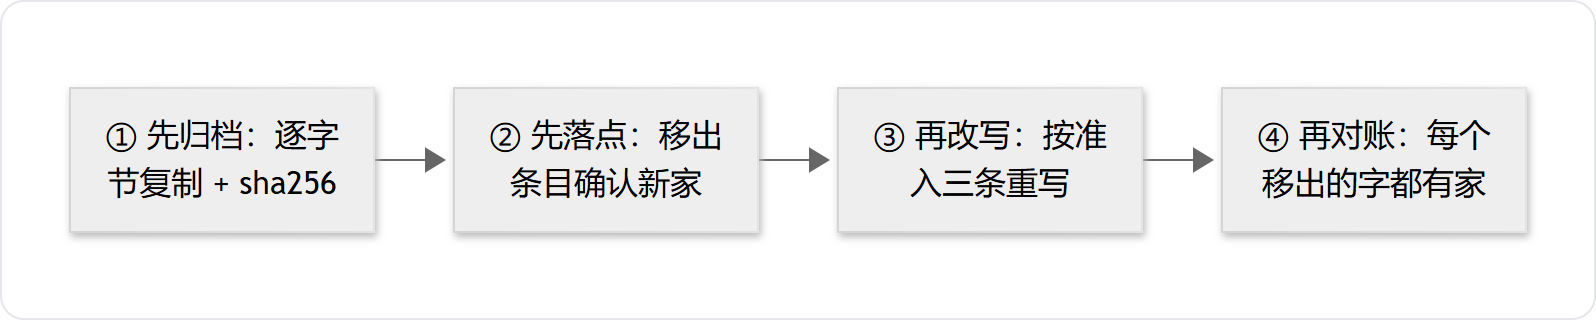
顺序即安全:四步
精简的安全性不取决于多小心,取决于顺序:
- 先归档:动手前把当前版逐字节复制成一份带日期的归档,记录哈希。回退点先存在,再谈其他。
- 先落点、后删除:每个将被移出的条目,先确认它在新家已经存在;找不到落点的,留在主文件(宁可主文件大一点)。
- 再改写:按准入三条重写主文件,头部换成新标准,挂上归档链。
- 最后对账:拿旧版逐条核对——每个被移出的字都要能在新版或某个落点里被找到。
顺带一个重要发现:这个记忆文件恰好不在任何版本控制里(我专门查证过)。没有 git 兜底时,第 1 步的归档就是唯一回退点——所以它不是"建议步骤",是前置条件。
把纪律变成脚本
规则写在文档里仍然靠自觉,所以做了两个小脚本,把两个"闸门"变成一条命令:
- 结构体检(
check-memory.js):头部声明的每个路径断链没有?文件体积到水位没有(20KB 软线 / 25KB 硬线)?归档链完整吗? - 内容对账(
check-entities.js):从旧版抽出「必须有家」的实体清单(服务器地址、密钥字段名、端口号、脚本名、版本哈希……),机器验证每个实体要么还在新版、要么在某个落点文档里能被检索到。
对账输出(节选;敏感实体名已泛化):
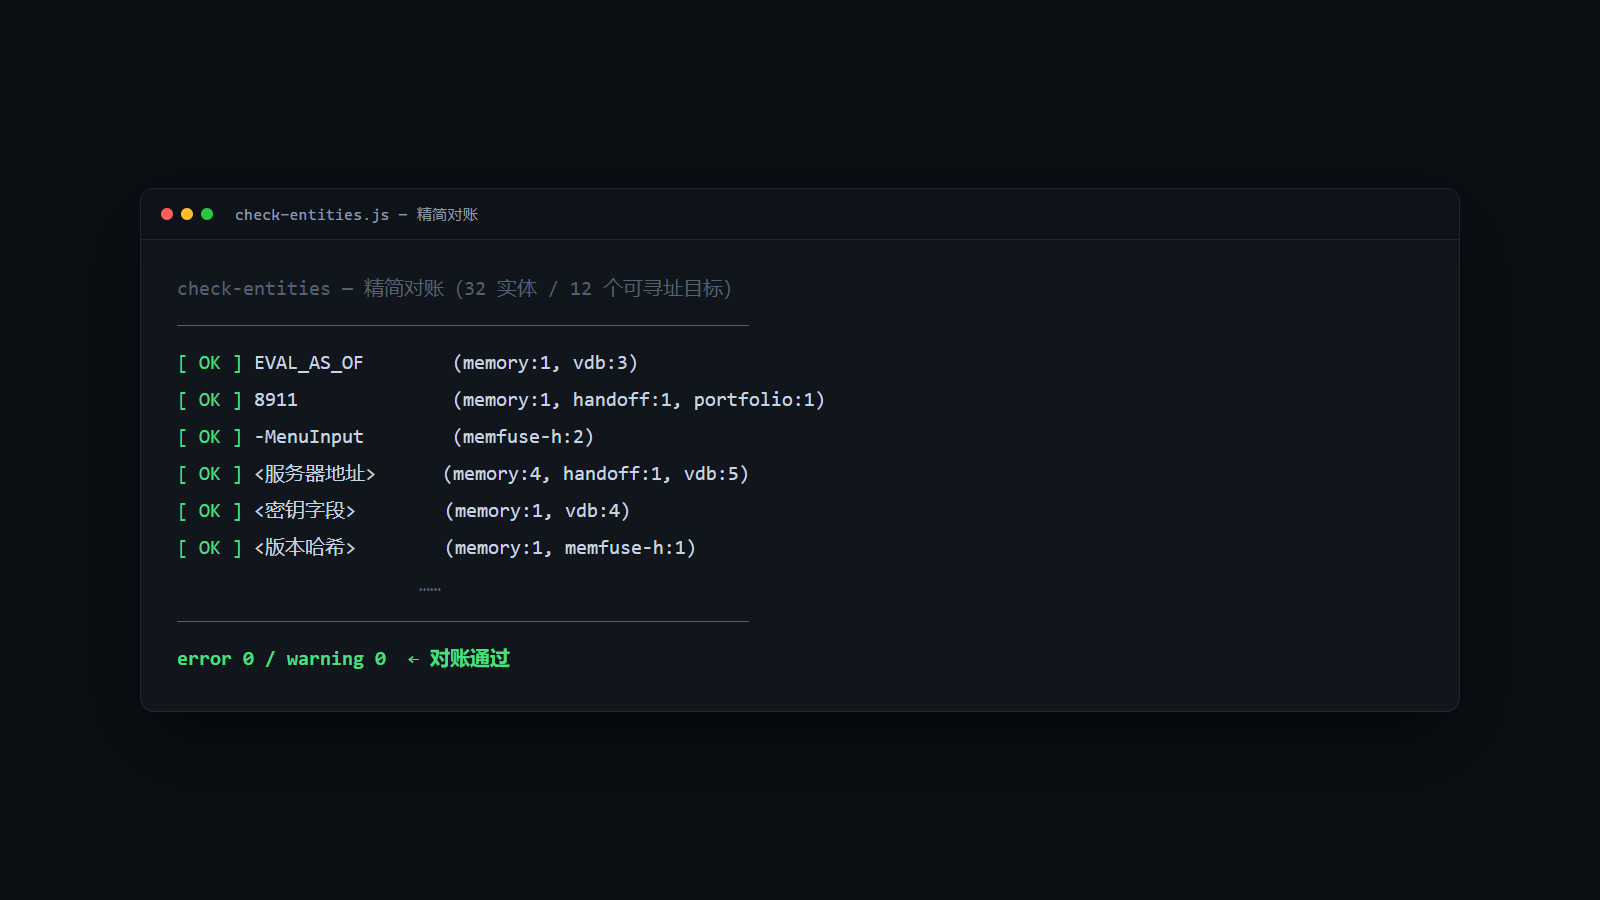
「只在归档里命中」会报 WARN(说明移出去了但落点没写),全 0 命中直接报 ERR。机器只认"可寻址",不认"我记得写过"。
这次的账
- 26 KB → 14.7 KB(-40.7%);行数不降反升——结构化后更好扫
- 32 个关键实体 × 12 个可寻址目标:对账全绿
- 归档链:连续两代全文归档 + sha256,可随时回退
- 结构变化:头部 = 准入三条 + 精简纪律;每个项目 = 状态 / 红线 / 改哪里
边界
诚实地讲这套方法的边界:
- 它是事后闸门,不是并发锁——多个会话同时写入时,只能在写完后靠对账发现,防不了"同时改同一处"这类冲突。
- "可寻址"能机器验证,"有没有用"不能——内容质量仍归人工判断。
- 准入三条是按我的场景定的判据,未必是所有人的最优解;但"搬迁式精简 + 机器对账"的骨架可以搬。
这套模式不限于某一家的记忆文件——任何"单文件长期记忆"(AGENTS.md、项目笔记、知识库索引页)都在此列。记忆不该是仓库,它是接力棒:每一棒都在,只是不再背着上一棒的全部重量跑。