从"事后看"到"事中拦":给流量观测工具装上告警规则引擎
一个自维护的本机流量观测工具,被三次真实事故各推着长出一个能力:20 小时静默停摆催生看门狗,单日 124GB 上行催生代理哨兵,一次 207GB 事故催生"本机连接"面板。最新一轮把写死阈值的哨兵泛化成告警规则引擎:任意进程 × 可组合条件 × Web 配置。本文记录这条演进路径与三个设计决策:为什么只告警不处置、为什么规则要能解释、以及为什么出口必须能兜底。
 眠月AI Agent 工程 · 全栈开发
项目:joker1point/flowwatch(MIT)。本文对应 2026-10 的告警规则引擎(规则表、评估守护、面板配置三件套)。
先说这个工具的尴尬:它每一秒都在采样、每秒都在算速率、每小时都在落历史库,然后把这一切画成面板——但面板只有人打开的时候才存在。如果异常发生在没人看的时候,它什么都做不了。三次真实事故,把这三个缺口一个一个打出来。
一、三次事故,三次补能力
这台机器上跑着一个自维护的流量观测工具。它先是一个"看板",后来长出了一层一层的能力,每一层背后都对应一次事故:
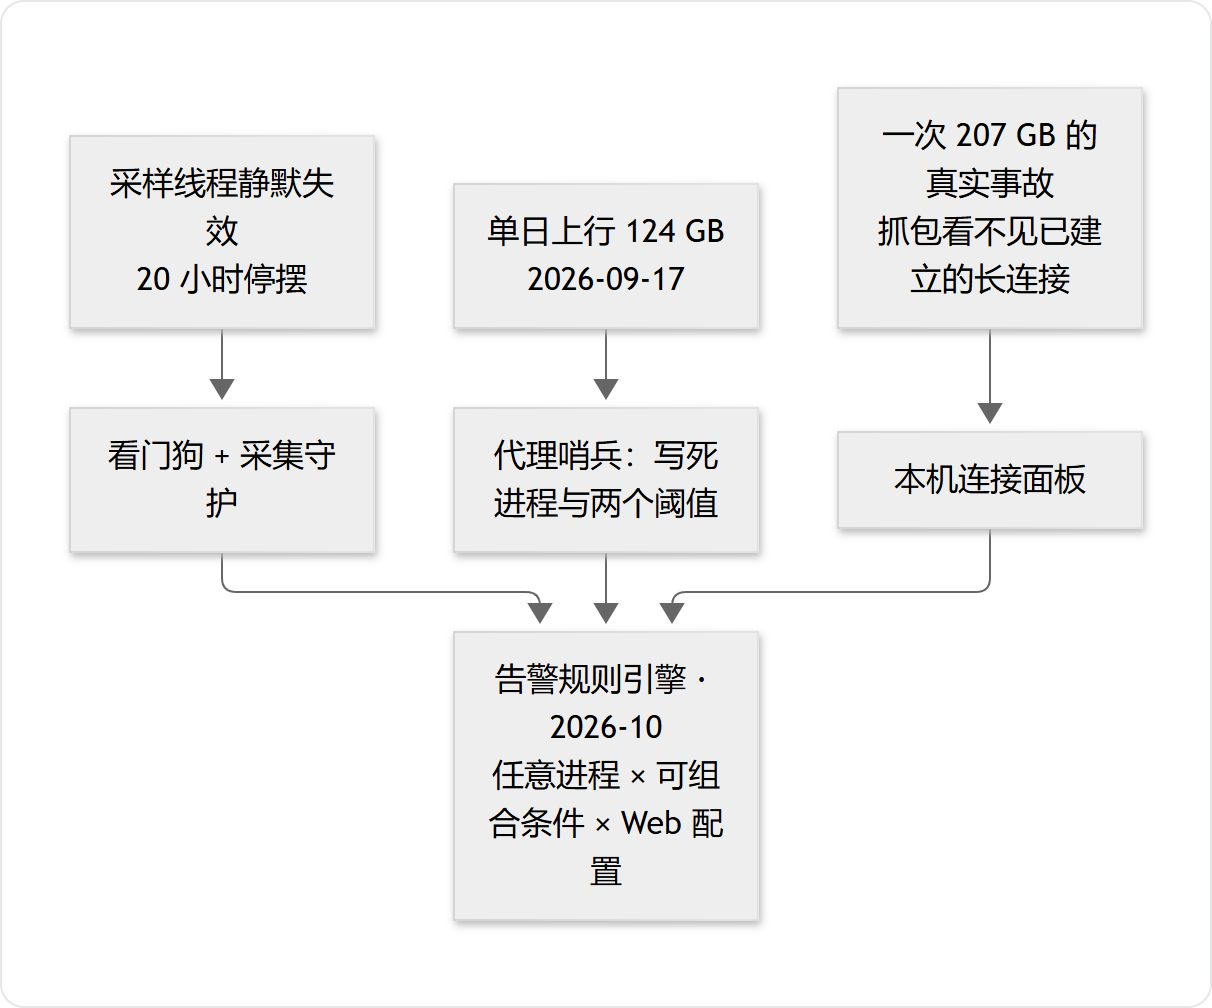
- 20 小时静默停摆:采样线程悄悄死掉,服务还活着、面板还能打开,只是数据不再更新——连"它挂了"这件事都需要有人先发现。于是有了看门狗:心跳超时就重启采集线程,并把每次重启记进日志。
- 单日上行 124 GB:某个代理进程因为重传风暴,一天往外推了 124 GB。发现问题靠的是运营商提醒,不是自己的工具。于是有了"代理哨兵":盯特定进程的窗口累计流量,超阈值就告警——但它把进程名和阈值都写死在脚本里。
- 一次 207 GB 的事故:这次是抓包层本身的盲区——已建立的长连接不再产生握手包,抓包视角里"看不见"它的存在,面板上也因此少了一整类流量。于是把操作系统的连接表纳进来,长出了一个"本机连接"面板。
三次事故的共同点:数据一直都在,缺的是"有人在看"。 前两个能力是防御性的补丁,第三个能力拆掉了一个观测盲区;而这一轮改版的目标是最后一层——让工具自己会看。
二、把写死的哨兵,泛化成规则引擎
旧的哨兵脚本只有一条规则:盯 %proxy% / %vpn% 这类进程名,30 分钟上行超过 5 GB、或 60 分钟超过 10 GB 就告警。它完成了使命,但三个局限很明显:换个客户端的名字就不触发、阈值改一次要动代码、只有一条规则没法表达"全机兜底"。
新的规则引擎把它泛化成三件事:任意进程 × 可组合条件 × Web 配置。
| 能力 | 说明 |
|---|---|
| 两类条件(可叠加) | window_bytes 窗口累计流量超限;sustained_minutes 持续传输时长超限。同一规则内 match=any(任一命中)或 all(全部命中) |
| 首个条件实例 | "近 60 分钟上行超过 10 GB"(全机,任何进程);"持续传输超过 60 分钟"(默认关闭,需要时一键开) |
| 诚实优先 | 分钟桶缺列(采集断过的时段)视为断裂——不把断线时间算成"连续传输" |
| 数据源 | 只读历史库的分钟桶表:每分钟每进程一行 |
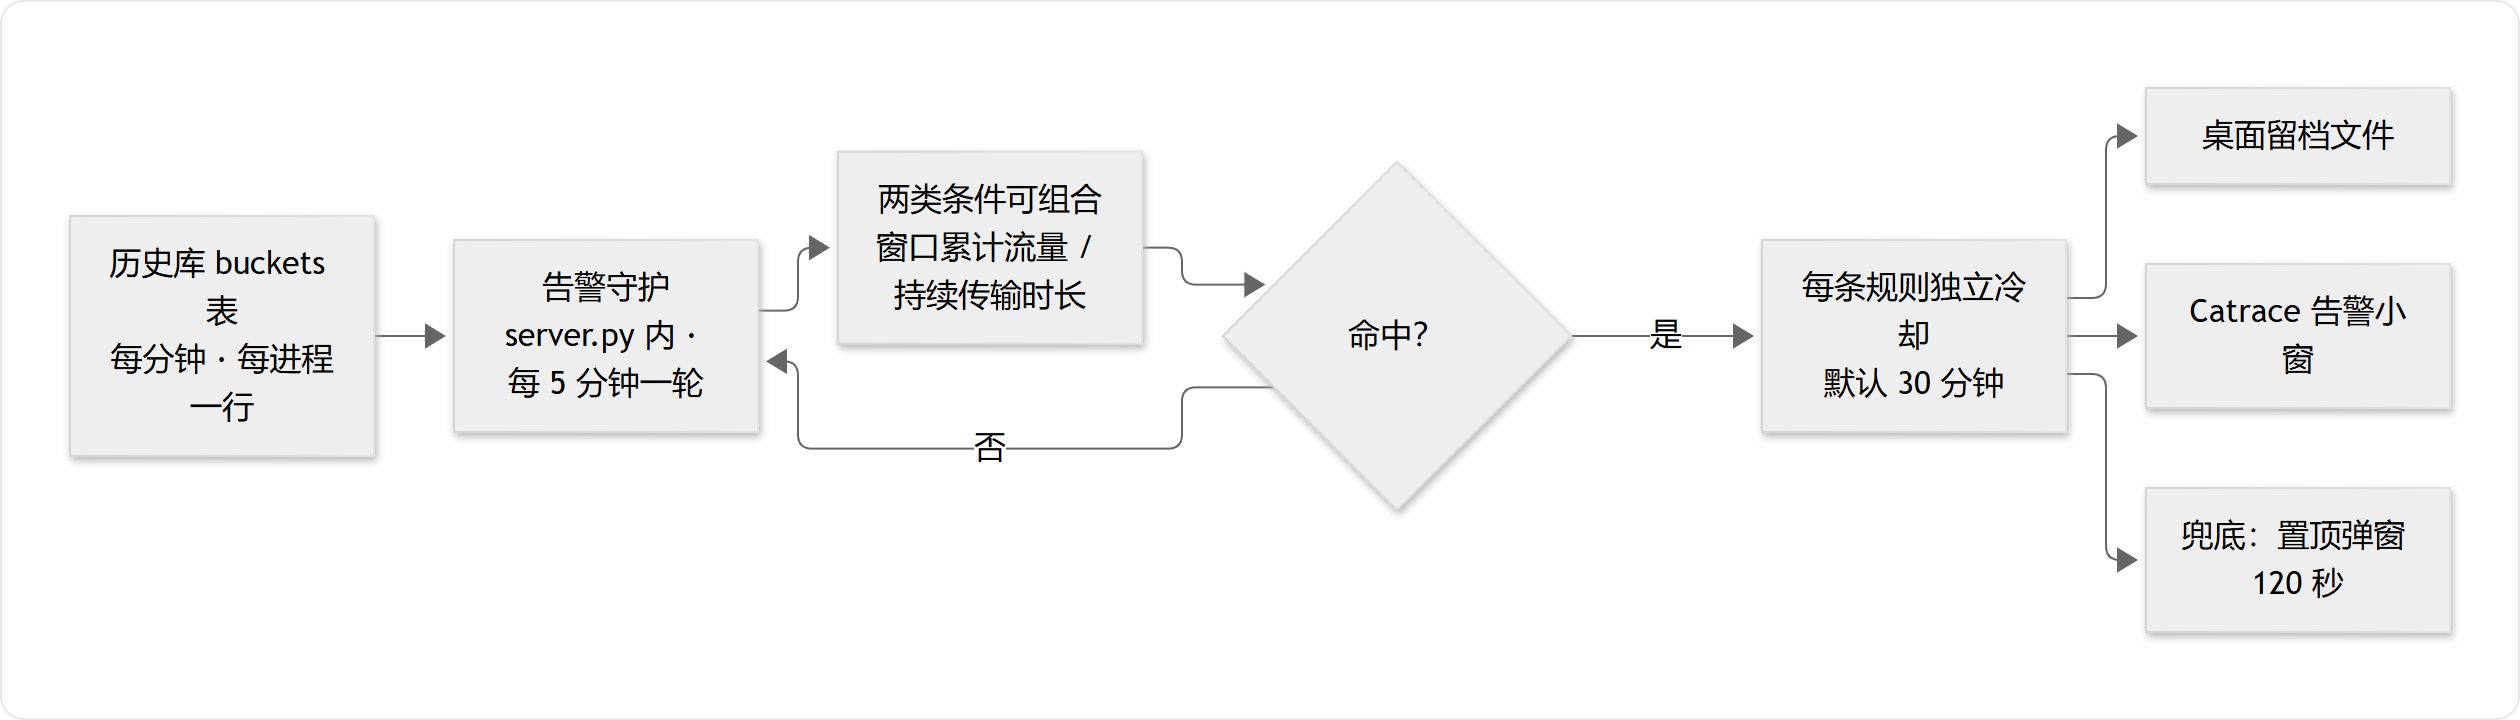
| 评估节奏 | 服务内起守护线程,每 5 分钟评估一轮;也可独立跑命令行 |
| 去抖 | 每条规则独立冷却(默认 30 分钟),冷却期内命中不重复弹 |
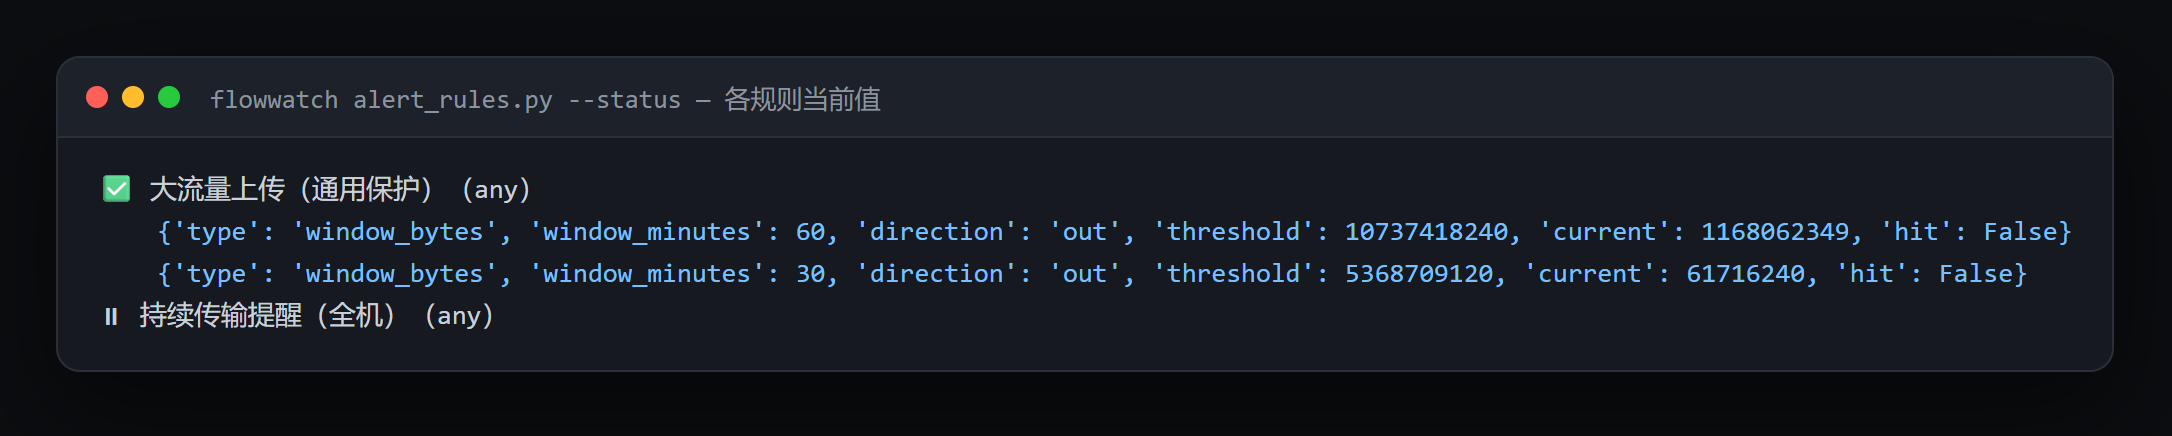
规则引擎的第一个设计约束是"可解释":命令行 --status 会把每条规则当前的值原样打印出来——规则名、条件类型、窗口、阈值、当前值、是否命中。规则不命中时,你能看到它离阈值还有多远;命中时,你能看到是哪一条条件的哪个数字越线。
第二个约束是"出口能兜底"。告警最怕的不是误报,而是报了但没人看见。现在的出口有三条,按"降级链"排列:桌面留档文件(永远可用)、桌面伴侣的告警小窗(装了就有)、置顶弹窗(前两条都不可用时的最后兜底,120 秒自动关闭,不打扰)。任何一条通道坏掉,下一条接上。
迁移也是这一刻完成的:引擎首次启用时,会把旧哨兵的保护等价种为默认规则——"保护不丢"是迁移的验收条件。旧脚本与它的计划任务随后退役。
三、面板降门槛:从"写通配符"到"点选进程"
规则引擎上线后,我请一位非开发者视角的朋友试着配一条规则,反馈很直接:「填这个对小白有点难度」。原表单要求自己写进程匹配串(%proxy% 这种通配符写法),还得理解"窗口 / 方向 / 阈值"三个字段的组合语义。
这轮改造做了三件事:一键模板(大流量上传、大流量下载、持续传输,点一下就是一条完整规则)、进程点选(把近 24 小时有流量的进程列成可点的标签,点一下就填好匹配,不用写通配符)、文案通俗化(字段旁给出"这行字会出现在告警里"的预览与校验引导)。
顺带清掉一个隐患:面板与校验提示里还残留着开发机特有的进程名(写死的示例都在用本机的客户端),全部泛化成中性示例——产品界面也是对外材料,构建产物全量扫描零命中才收工。
四、为什么是"事中拦",而不是"事后看"——以及它的边界
有人会问:既然能检测,为什么不直接阻断(比如自动断开流量异常的连接)?这是这个工具明确不做的一件事。
它不碰网络栈:不改路由、不断连接、不封端口。判断权与处置权都留给使用者。原因有两个:误伤代价高(你可能正在上传一个大文件,或者那个"异常"进程恰好在替别的程序正常转发);以及一旦能处置,它就从"观测工具"变成了"处置工具",责任面完全不同。
边界还要说得更细一点:现阶段的规则是基于进程与流量形态的——"某个进程在某个窗口里的字节数"。它能抓住"这台机器在异常地上传",但抓不住"这个进程为什么异常";换一个不在匹配范围内的客户端,也可能不触发。这些盲区不如实说清楚,工具就会给人一种它没有的安全感。
五、形态收束:少一个进程,多一个标签页
功能加完后,界面入口也收敛了一轮。曾经做过"再起一个服务专门开界面"的方案,被否掉了——这台机器内存常年高压,任何"第二服务 + 第二采集器"都是压垮项。最终形态是零新增进程:常驻的采集服务如果检测到前端构建产物存在,就同源挂载界面——想看一眼的时候,秒开只多一个浏览器标签;不想看的时候,它还是那个安静的采集进程。
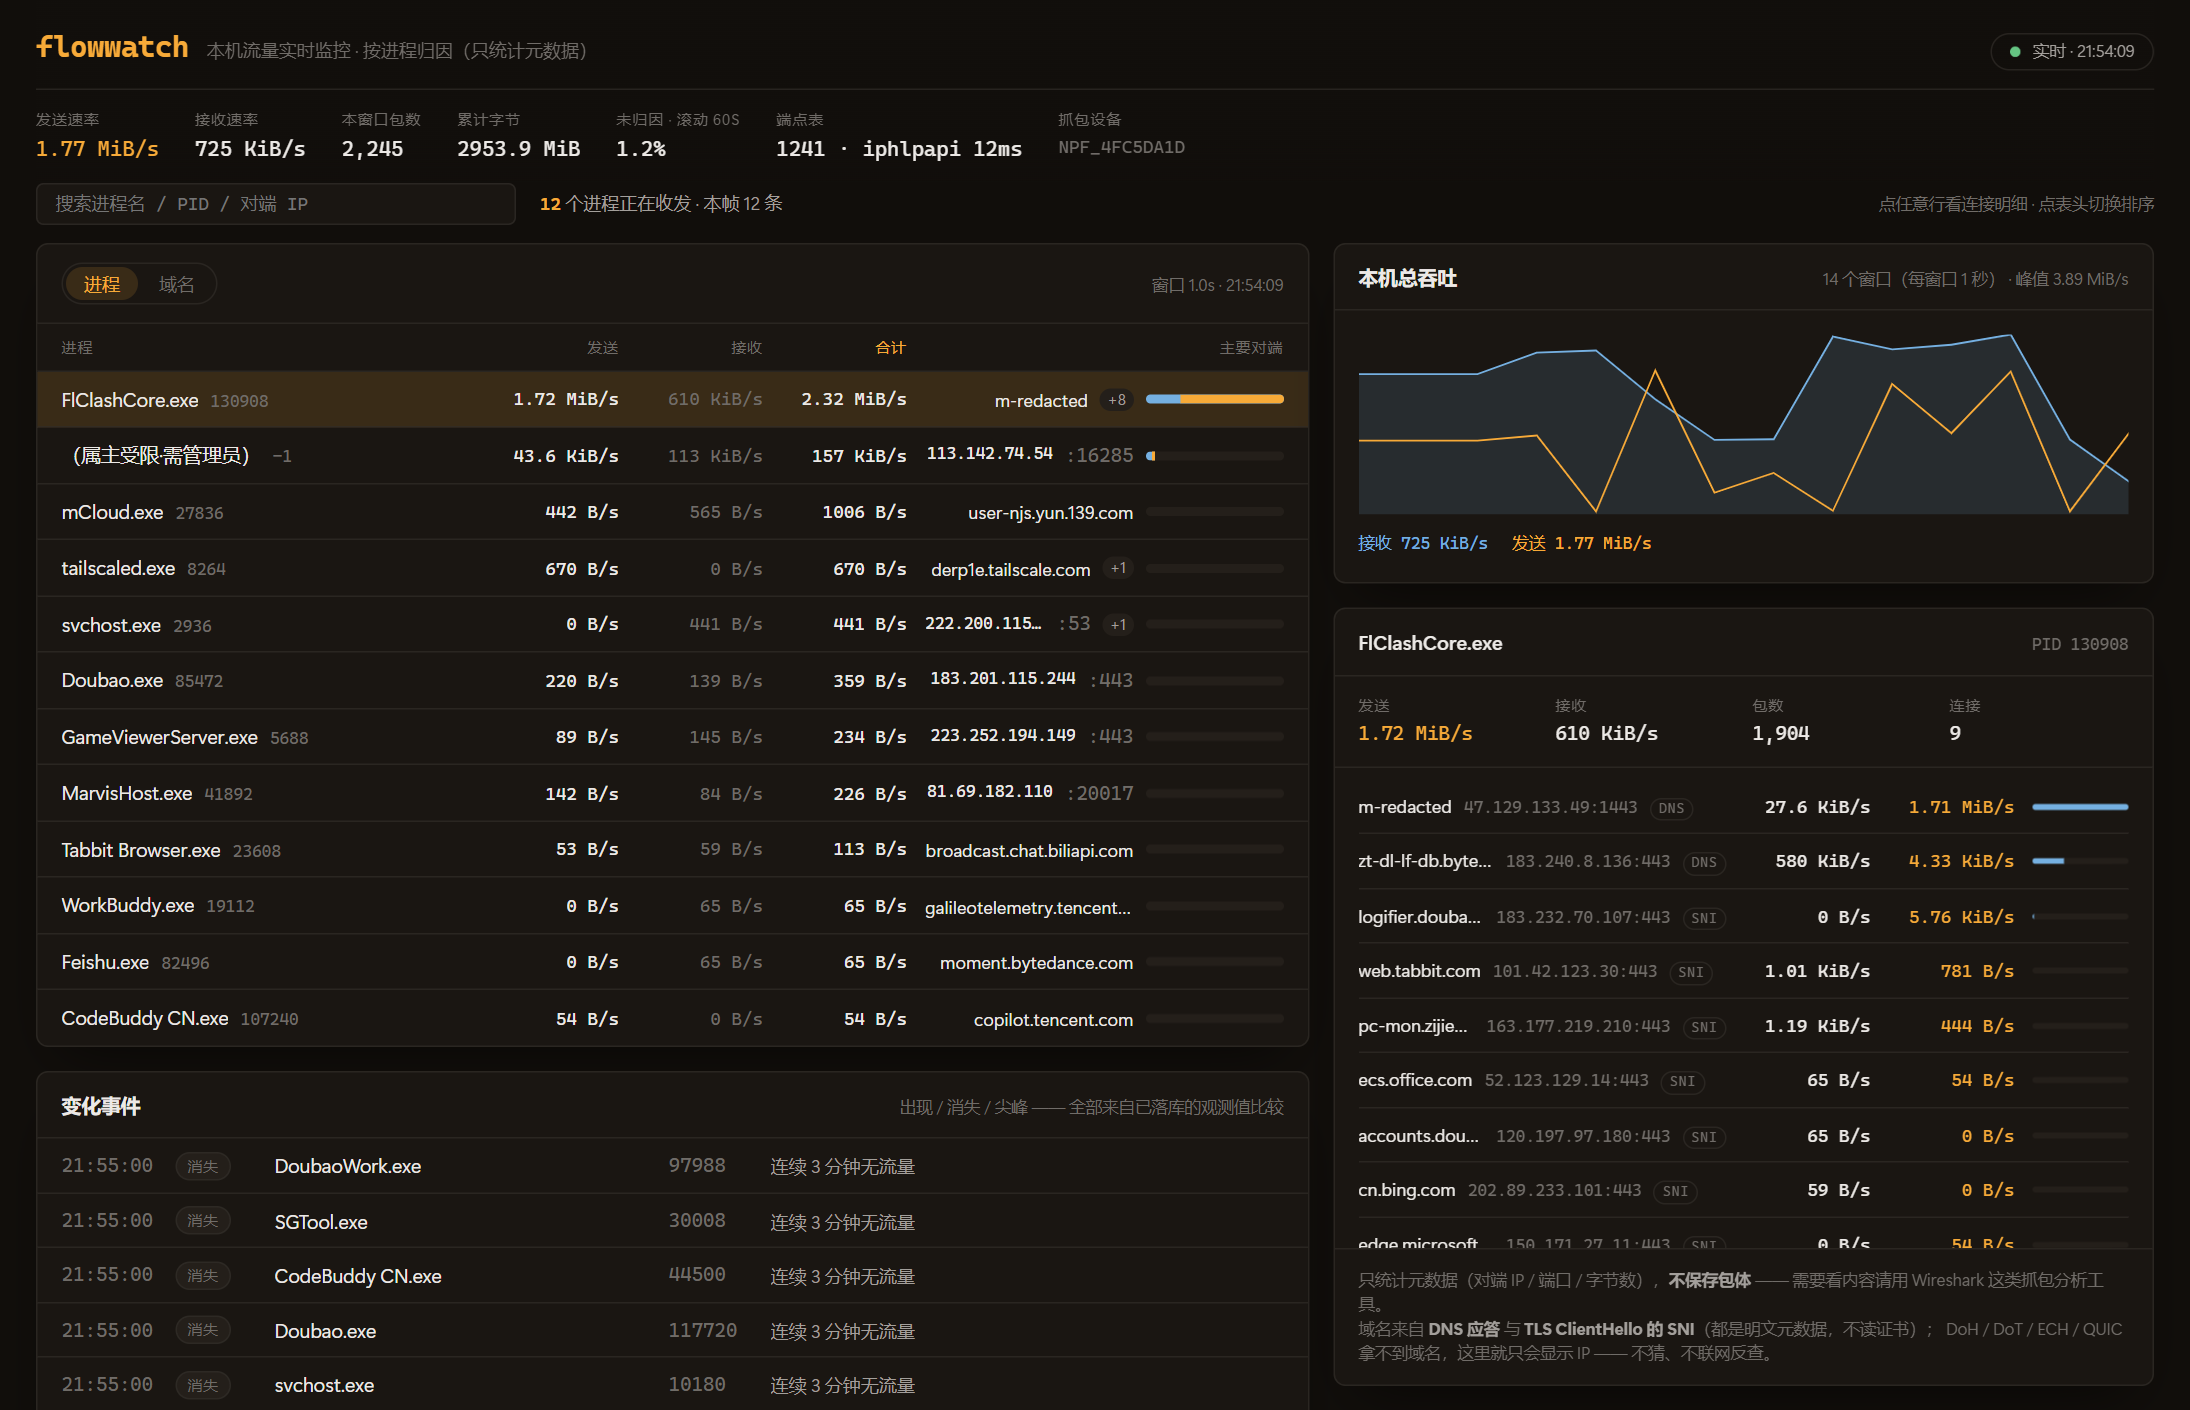
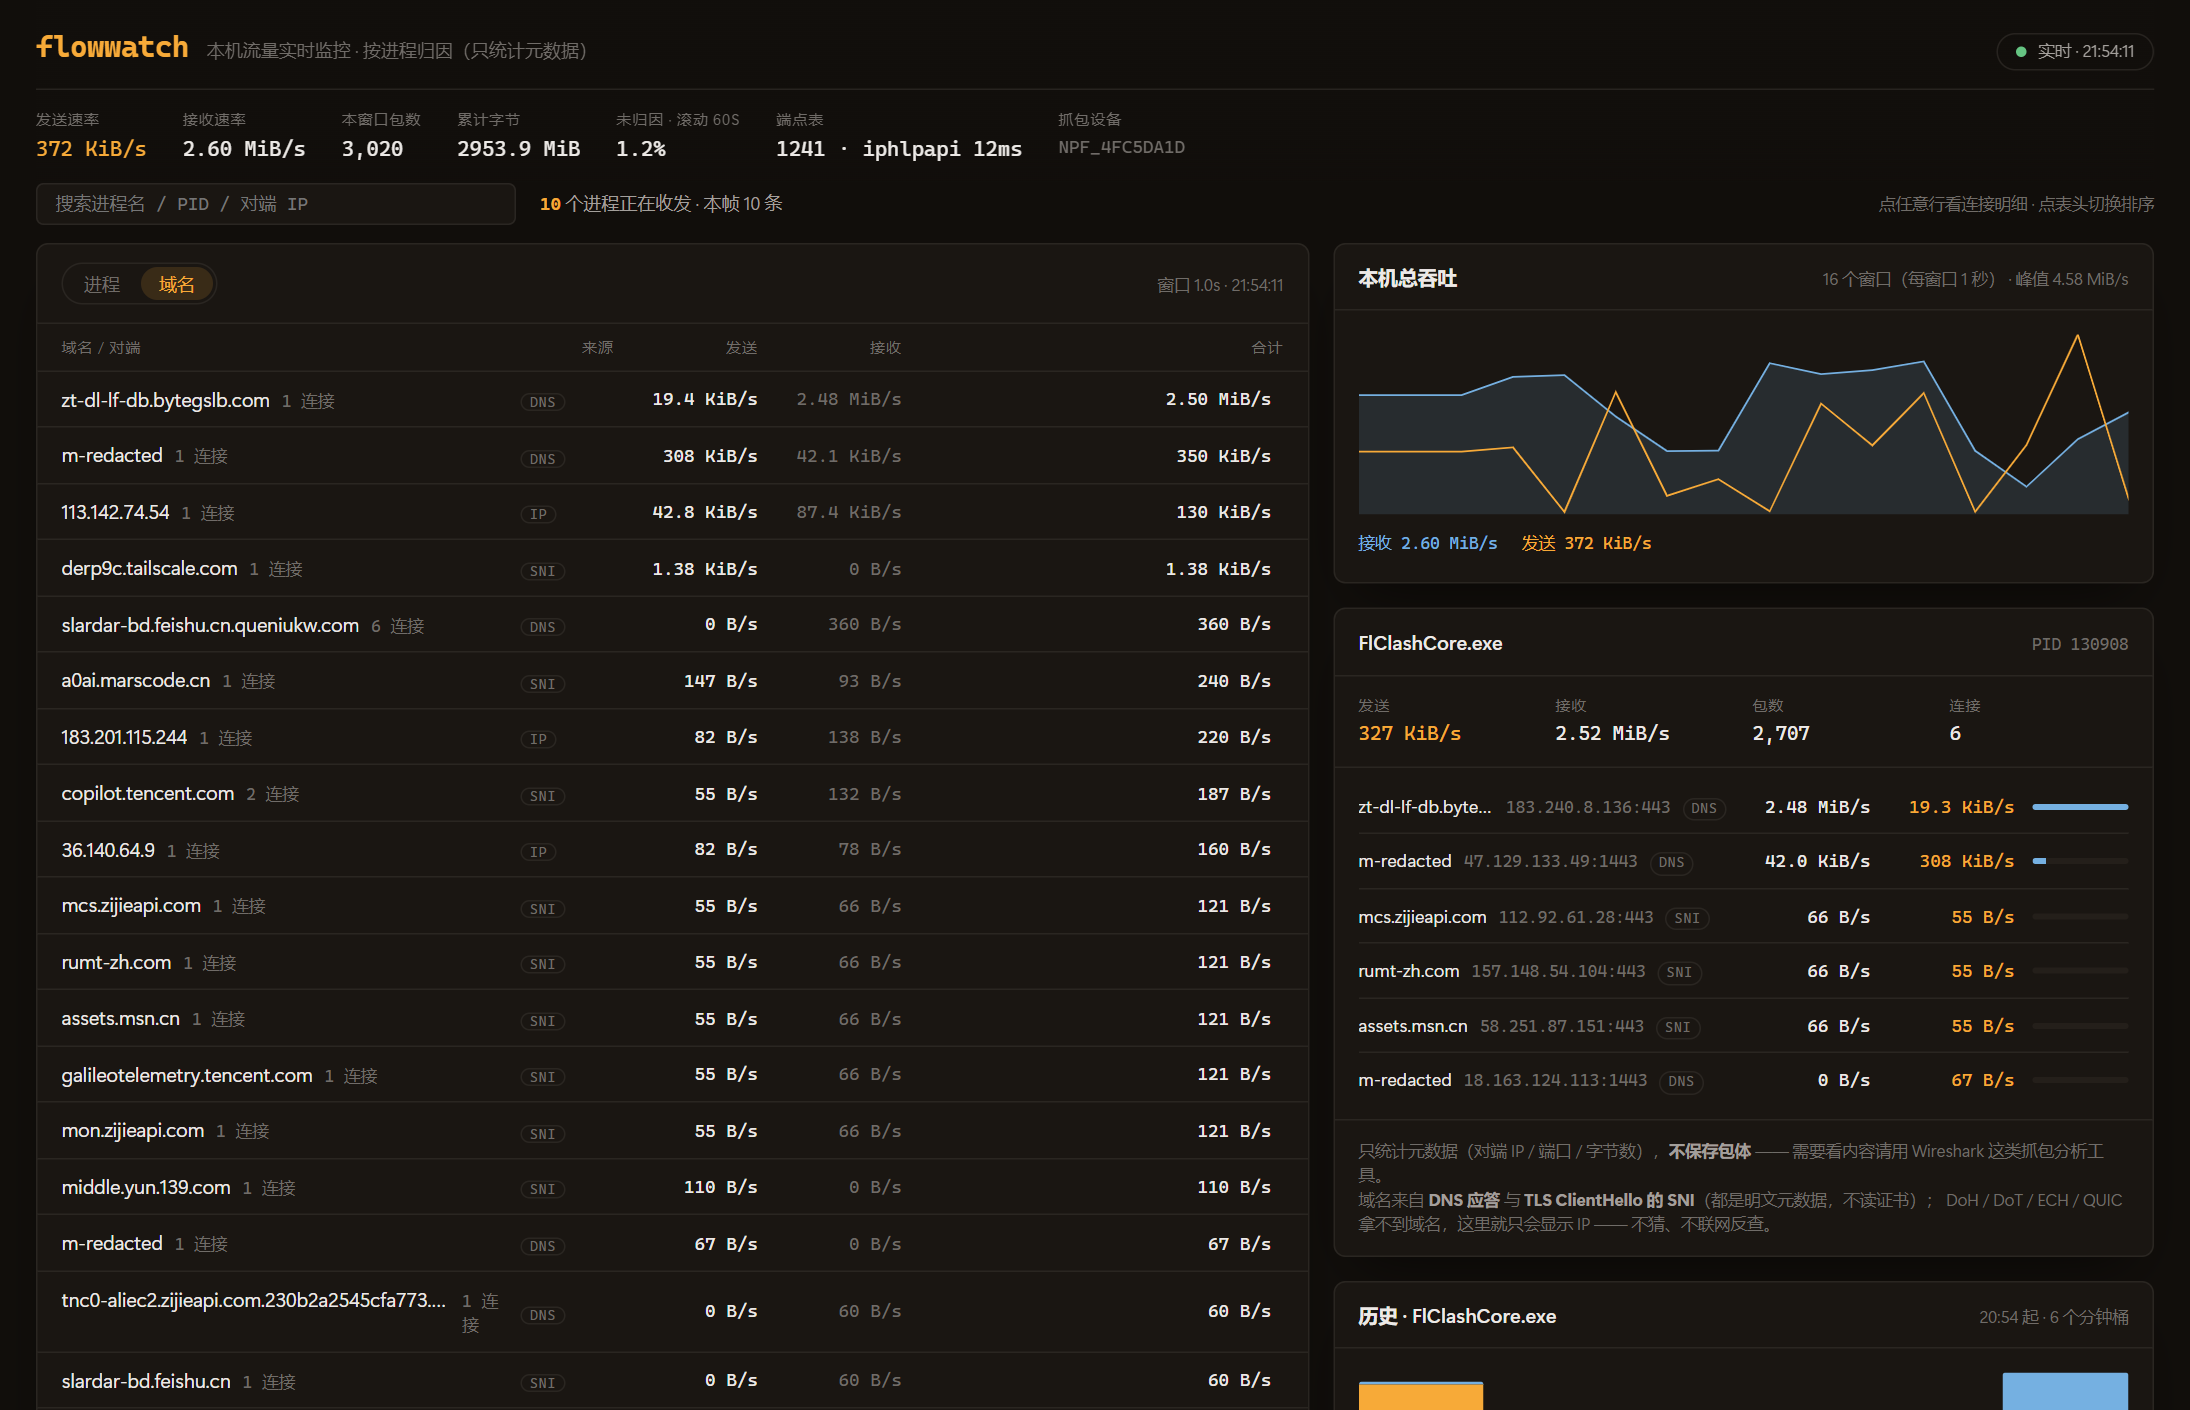
从"看板"到"看门狗"、到"哨兵"、到"规则引擎",这条路径上没有任何一步是规划出来的——都是被事故推着走的。如果总结一句经验:观测工具的价值不在它采集了多少,而在异常发生时它有没有替你看、并且把结论送到你眼前。 规则引擎这一层做的,就是把"看"从人转移到工具,同时把"拦住"的决定权,仍然留在人手里。